

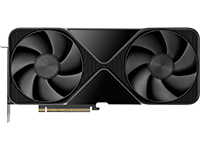
NVIDIA RTX PRO 6000 Blackwell Workstation Editionは、NVIDIA Blackwell アーキテクチャを採用し、96GBのGDDR7メモリーを搭載したプロフェッショナル向けワークステーションGPUです。AI処理性能とグラフィックス性能を両立し、要求の厳しいクリエイティブワークフローや研究開発ワークロードに対応します。Blackwell ストリーミングマルチプロセッサー(SM)はGPUあたり最大24,064基のCUDAコアを搭載し、FP32スループットは前世代比で最大1.4倍に向上。最大125TFLOPSの単精度性能により、産業用シミュレーションや3Dモデリングを高速化します。96GBの大容量メモリーにより、大規模言語モデルのローカル推論や高解像度の3Dシーンをメモリー上に保持したまま処理でき、モデル分割やスワップによるオーバーヘッドを回避できます。消費電力に余裕のある筐体で最大性能を引き出したい場合に適した構成です。当社では、最新の高負荷GPUカードが安定して性能を発揮できるよう、NVIDIAおよびベアボーンメーカーと連携し、ハードウェア、OS、ミドルウェア、開発ツールまで最適化した状態でご提供します。
このカードを搭載したモデルはこちらから
DeepLearningBOX III
DeepLearningSTATION II
※ジーデップ・アドバンスのサーバー、ワークステーションは最新の高負荷GPUカードが安定して最高のパフォーマンスが発揮できるよう、NVIDIA社やベアボーンメーカーと連携し、ハードウェア・OS・ミドルウェア・開発ツールまで最適化した形でご提供しています。
- Blackwell
- PCIe 5.0
- GDDR7
- 96GB
- [FP32] 125 TFPS
- FP4 /8 /16演算性能
- 3年保証
プロフェッショナル向けのパフォーマンスと機能

NVIDIA Blackwell アーキテクチャー
また、Blackwell ストリーミング マルチプロセッサ(SM) は、GPU あたり最大24,064 のCUDA コアを搭載し、最大125TFLOPS の単精度のパフォーマンスを実現し、産業用シミュレーションや 3D モデリングを加速します。

高帯域で大容量なGDDR7 メモリ
最大96GB のGPU メモリで大規模な3D プロジェクトやAI プロジェクトに対応し、VR 環境の探索やマルチアプリケーションのワークフローを効率的に処理します。また、GDDR7メモリは、レイトレーシング、レンダリング、およびAIワークロードを加速するために、最大2 倍のメモリ帯域幅を実現します。
NVIDIA RTX PRO™は、レイテンシに対して敏感なプロフェッショナルアプリケーションにおいて、最大のデータセットとモデルに対応するために業界最高のメモリ容量を搭載しています。

PCIe Gen5

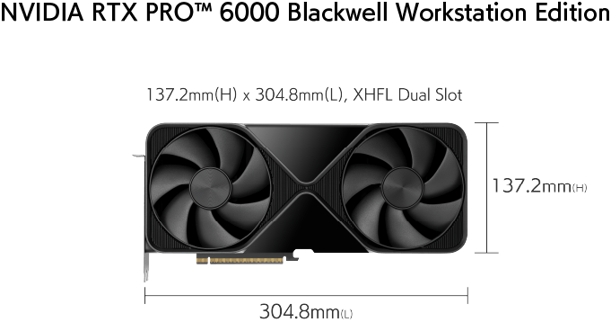
製品サイズ

| 製品名 | 6000 Blackwell Workstation Edition |
|---|---|
| アーキテクチャ | NVIDIA Blackwell |
| 製造プロセス | NVIDIA カスタムプロセス 4N |
| トランジスター数 | 92.2 billion |
| ダイサイズ | 750 mm² |
| CUDAコア数 | 24,064 |
| Tensorコア数 | 752(第5世代) |
| RTコア数 | 188(第4世代) |
| 単精度演算性能 | 125 TFLOPS |
| AI性能 | 4,000 AI TOPS |
| RTコア性能 | 380 TFLOPS |
| GPUメモリ容量 | 96 GB GDDR7(ECC対応) |
| インターフェース | 512-bit |
| メモリ帯域幅 | 1,792 GB/s |
| 消費電力 | 600 W |
| Multi-Instance GPU | 最大 24 GB x4 |
| 最大 48 GB x2 | |
| 最大 96 GB x1 | |
| グラフィックバス | PCIe 5.0 x16 |
| ディスプレイポート | DisplayPort 2.1b x4 |
| サイズ | 137 mm(W) × 304 mm(H) Dual-Slot GPU |
| 重量 | 1.95 kg |
| 冷却方式 | ダブルフロースルー |
| NVIDIA 3D Vision / 3D Vision Pro | 3ピン mini-DIN経由で対応 |
| フレームロック | 対応(NVIDIA RTX PRO Sync) |
| 電源コネクター | PCIe CEM5 16ピン x1 |
| NVENC / NVDEC / JPEG | x4 / x4 / x4 |
- NVIDIA® グラフィックボード
- NVIDIA® RTX PRO™ 6000 Blackwell Workstation
- NVIDIA® RTX PRO™ 6000 Blackwell Max-Q
- NVIDIA RTX PRO™ 5000 Blackwell
- NVIDIA RTX PRO™ 4500 Blackwell
- NVIDIA RTX PRO™ 4000 Blackwell
- NVIDIA RTX PRO™ 4000 Blackwell SFF Edition
- NVIDIA® コンピューティングボード
-
ご購入に関するご相談・お問い合わせ
-
uniVは完全オーダーメイドで
お客様のご希望の仕様に合わせて
製造することが可能です。
お気軽にお問い合わせください。
-