


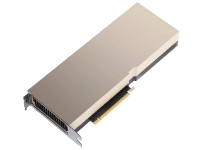
NVIDIA® H200 NVL 141GB PCIeは、NVIDIA Hopper アーキテクチャを採用し、141GBのHBM3eメモリーと4.8TB/秒のメモリー帯域幅を備えた、生成AI向けのTensorコアGPUです。700億パラメーターの大規模言語モデル「Llama 2 70B」の推論では前世代のNVIDIA H100と比較して1.9倍、1750億パラメーターの「GPT-3 175B」の推論では1.6倍に高速化します。HPCアプリケーションでは、CPU(Intel Xeon Platinum 8480+ 2ソケット)と比較して110倍の高速化を実現します。大容量のGPUメモリーにより、これまでメモリー不足で分割が必要だった大規模モデルも1基のGPU上で扱えるようになり、学習・推論の設計自由度が高まります。さらに2枚のH200 NVLをNVLinkで接続することで、合計282GBのメモリー空間を構成でき、GPU間は900GB/秒の帯域で通信可能。大規模AIモデルの学習に適した構成を実現します。本製品にはNVIDIA AI Enterpriseの5年間サブスクリプションが付属し、導入直後から検証済みのAI開発環境を利用できます。
※本製品は消費電力が非常に高いため、NVIDIAが認定したシステムにのみ搭載できます。動作認証済のシステムや搭載方法については当社にご相談ください。
※NVLinkによるGPU接続は、NVIDIA H200 NVLを2枚接続する場合に有効です。異なるGPUカードとの接続は動作保証外となりますのでご注意ください。
| NVIDIA H100 PCIe | NVIDIA H100 NVL | NVIDIA H200 NVL | |
| アーキテクチャ | Hopper | Hopper | Hopper |
| FP64 | 24TFLOPS | 30TFLOPS | 30TFLOPS |
| FP64 Tensorコア | 30TFLOPS | 60TFLOPS | 60TFLOPS |
| FP32 | 30TFLOPS | 60TFLOPS | 60TFLOPS |
| TF32 Tensorコア(※1) | 395TFLOPS | 835TFLOPS | 835TFLOPS |
| BFLOAT16 Tensorコア(※1) | 395TFLOPS | 1,671TFLOPS | 1,671TFLOPS |
| FP16 Tensorコア(※1) | 1,513TFLOPS | 1,671TFLOPS | 1,671TFLOPS |
| FP8 Tensorコア(※1) | 3,026TFLOPS | 3,341TFLOPS | 3,341TFLOPS |
| INT8 Tensorコア(※1) | 3,026TOPS | 3,341TOPS | 3,341TOPS |
| GPUメモリー | 80GB HBM2e | 94GB HBM3 | 141GB HBM3e |
| GPUメモリー帯域幅 | 2TB/秒 | 3.9TB/秒 | 4.8TB/秒 |
| デコーダー | NVDEC 7基 | NVDEC 7基 | NVDEC 7基 |
| TDP | 350W | 350〜400W(設定可能) | 最大600W(設定可能) |
| マルチインスタンスGPU(MIG) | 最大7個(第3世代) | 最大14個(各12GB) | 最大7個(各16.5GB) |
| フォームファクター | PCIe デュアルスロット | PCIe デュアルスロット | PCIe デュアルスロット |
| 冷却方式 | Passive(パッシブ) | Passive(パッシブ) | Passive(パッシブ) |
| NVIDIA AI Enterprise | 付属(5年間) | 付属(5年間) | 付属(5年間) |
| 保証 | 3年 | 3年 | 3年 |
※1 疎性(Sparsity)を利用した場合の値です。
レンタルでの導入も可能
GPUレンタルには、初期投資を抑えられるというメリットがあります。高性能なGPUを購入することなく、必要な期間だけご利用いただけるため、コスト効率を重視される場合にお勧めです。ご希望の場合は、見積もり画面からお選びいただけます。
このカードを搭載したモデル
※当社のサーバー、ワークステーションは、最新の高負荷GPUカードが安定して性能を発揮できるよう、NVIDIAおよびベアボーンメーカーと連携し、ハードウェア、OS、ミドルウェア、開発ツールまで最適化した形でご提供しています。
- Hopper
- PCIe 5.0
- HBM3e
- 141GB
- FP16/ FP8演算性能
- [FP32]60 TFLOPS
- [FP64]30 TFLOPS
- 3年保証
大容量で高速なHBM3eメモリによる高いパフォーマンス
NVIDIA Hopper アーキテクチャをベースとする NVIDIA H200 は、毎秒 4.8 テラバイト (TB/s) で 141 ギガバイト (GB) の HBM3eメモリを提供する初の GPU です。
これは、NVIDIA H100 Tensor コア GPU の約 2 倍の容量で、メモリ帯域幅は 1.4 倍です。H200 の大容量かつ高速なメモリは、生成 AI と LLM を加速し、エネルギー効率を向上させ、総所有コストを低減し、HPC ワークロードに最適化されています。


LLM・推論速度がH100と比較して最大 2倍向上
LLMを円滑に稼働させるためには、高性能なコンピュータが必要不可欠です。NVIDIA H200 AIアクセラレータは、この課題を解決する画期的なGPUです。700億パラメータの大規模言語モデル 「Llama2 70B」の推論を前モデルである、NVIDIA H100と比較して1.9倍、1750億パラメータの大規模言語モデル「GPT3-175B」の推論で1.6倍高速化し、LLMの処理速度を最大約2倍に向上させることで、より多くのユーザーに、より迅速かつ高品質なAIサービスを提供することが可能になります。


HPCアプリケーションに対してデータ転送110倍に高速化(対CPU)
NVIDIA H200は、膨大なデータを高速に処理する能力に長けたGPUです。GPUはデータの読み書き速度を示す指標としてメモリ帯域幅があり、H200は前モデルのH100 80GBの2.0TB/s、H100 NVL 94GBの3.9TB/s からさらに進化して4.8TB/s のメモリ帯域をもっています。スーパーコンピューターで複雑な計算を行う場合、大量のデータをメモリーとCPUの間で何度もやり取りが行われるのですが、これがボトルネックとなり計算速度が遅くなってしまうことがあります。
NVIDIA H200は、このボトルネックを解消するために、4.8TB/sと非常に高いメモリ帯域幅を実現しています。データをスムーズにやり取りできるため、シミュレーションやAIの学習など、大規模な計算を短時間で処理することが可能です。
また、H200は従来のCPU (Xeon® Platinum 8480+ 2CPU) と比べて、110倍の速さでデータを処理でき、高速なメモリ帯域幅は、科学研究やAI開発など技術革新を加速させる上で不可欠な存在となります。


エネルギーとTCOの効率化
NVIDIA H200は、驚異的な性能を発揮しながらも、同時にTCO(総所有コスト)を大幅に削減できる画期的なGPUです。
前世代のH100と同等の電力消費量でありながらはるかに高いパフォーマンスを実現します。AIモデルの学習や、大規模なシミュレーションなど、高度な計算処理を必要とする分野においてこの高いエネルギー効率は、電気料金の削減に直結し、TCOを大幅に抑えることに貢献します。
高いエネルギー効率を実現することで消費電力を削減し環境負荷を軽減します。これは、サステナビリティ社会の実現に向けた重要なファクター言えるでしょう。


NVIDIA AI Enterprise エンタープライズサポートを含む5年のソフトウェアサブスクリプションが付属
NVIDIA H200とNVIDIA AI Enterpriseの組み合わせは、AI 対応プラットフォームの構築が簡素化され、生成AIやコンピュータビジョンなど、多様なAIモデルの開発と導入を加速させ、企業レベルのセキュリティと安定性を確保します。AI開発者は複雑な環境設定に煩わされることなく、AIモデルの開発に集中することができます。
これらの要素が組み合わさることで、企業はAIの導入障壁を下げ、より迅速にビジネスにAIを導入し、競争優位性を確立することができます。
NVIDIA H200には5年間分のNVIDIA AI Enterprise ソフトウェアとサポートが含まれています。


2. With sparsity.

- NVIDIA® グラフィックボード
- NVIDIA® コンピューティングボード
- NVIDIA RTX PRO 6000 Blackwell Server Edition
- NVIDIA® H200 NVL 141GB PCIe
- NVIDIA® A800 40GB Active


-
ご購入に関するご相談・お問い合わせ
-
uniVは完全オーダーメイドで
お客様のご希望の仕様に合わせて
製造することが可能です。
お気軽にお問い合わせください。
-