



納期のご案内
12月入荷予定・台数限定
現在ご注文分の入荷は2026年12月を予定しております。入荷台数に限りがございますので、ご検討中のお客様はお早めにご相談ください。
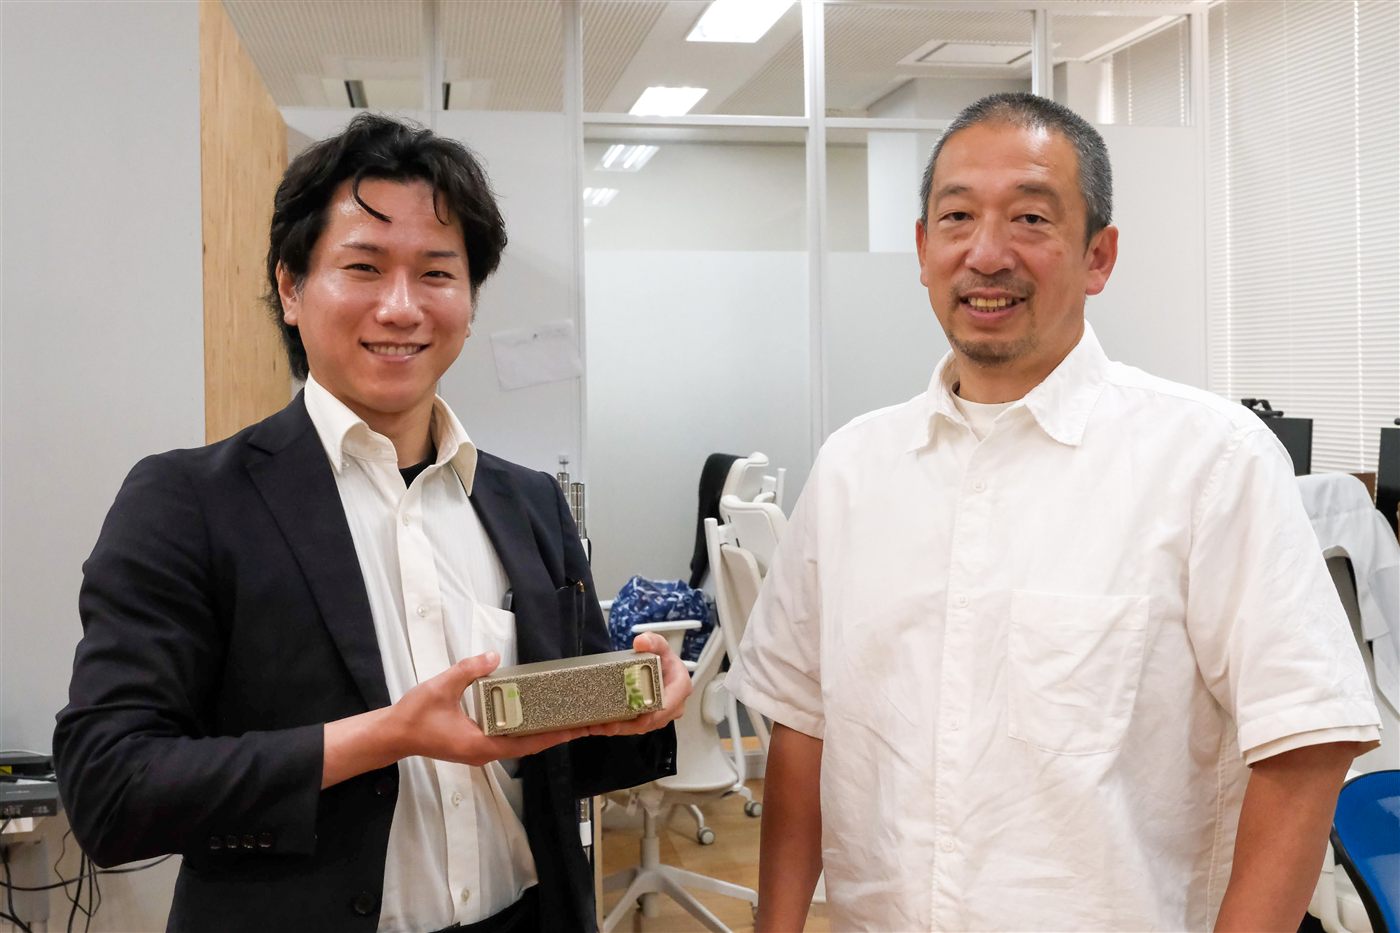
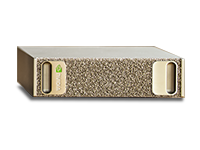
NVIDIA DGX Sparkは、NVIDIA GB10 Grace Blackwell Superchipを搭載した、デスクトップ設置型のパーソナルAIスーパーコンピューターです。生成AIモデルの大規模化と複雑化により、ローカル環境でのプロトタイピングやファインチューニングが難しくなっています。大規模モデルをローカルで扱うには大容量のメモリーと高い演算性能が必要であり、DGX Sparkはその要件をデスクトップのフォームファクターで満たします。GB10は第5世代TensorコアとFP4に対応したBlackwell GPUを搭載し、NVIDIA Cosmos Reason 世界基盤モデルやNVIDIA GR00T N1 ロボット基盤モデルを含む最新モデルのファインチューニングと推論において、毎秒最大1,000兆回のAI演算を実現します。GB10はNVIDIA NVLink-C2C相互接続技術により、第5世代PCI Expressの5倍の帯域を持つCPU+GPUコヒーレントメモリーモデルを構成し、メモリー消費の大きいAI開発ワークロードの性能を最適化します。NVIDIAのフルスタックAIプラットフォームにより、デスクトップからNVIDIA DGX Cloudやデータセンターへモデルをそのまま移行でき、研究者やデータサイエンティスト、ロボティクス開発者の試行錯誤を加速します。
NVIDIA DGX Spark 導入事例
- NVIDIA Grace
- 1CPU
- Blackwell
- 1GPU
- 20Core
- LPDDR5x
- 128GB
- Uunified Memory
- Blackwell
- 1年保証
AIの時代のためにゼロから設計された新しいクラスのコンピューター
NVIDIA DGX Sparkは従来クラウドやデータセンターのリソースが必要だった大規模な AI ワークロードに取り組んでいる AI 開発者、研究者、データ サイエンティスト、学生向けに設計されています。デスクトップシステムでありながら、1,000 TOPSのAIパフォーマンス(FP4精度)と128GBのコヒーレント統合システムメモリを提供し、開発者がデスクで最大2,000億のパラメータ、128GBのunifiedシステムメモリによりAIモデルの開発、推論を可能にします。
さらに、NVIDIA ConnectX™ ネットワーキングにより、2台のNVIDIA DGX Sparkスーパーコンピュータを接続し、最大405Bパラメータのモデルの推論を可能にします。非常に小さなフォーム ファクター(重量わずか1.2キロ、 L150mm x W150 mm x H50.5 mm )で既存のラップトップやデスクトップシステムでは実行できないAIモデルやワークロードに対応します。
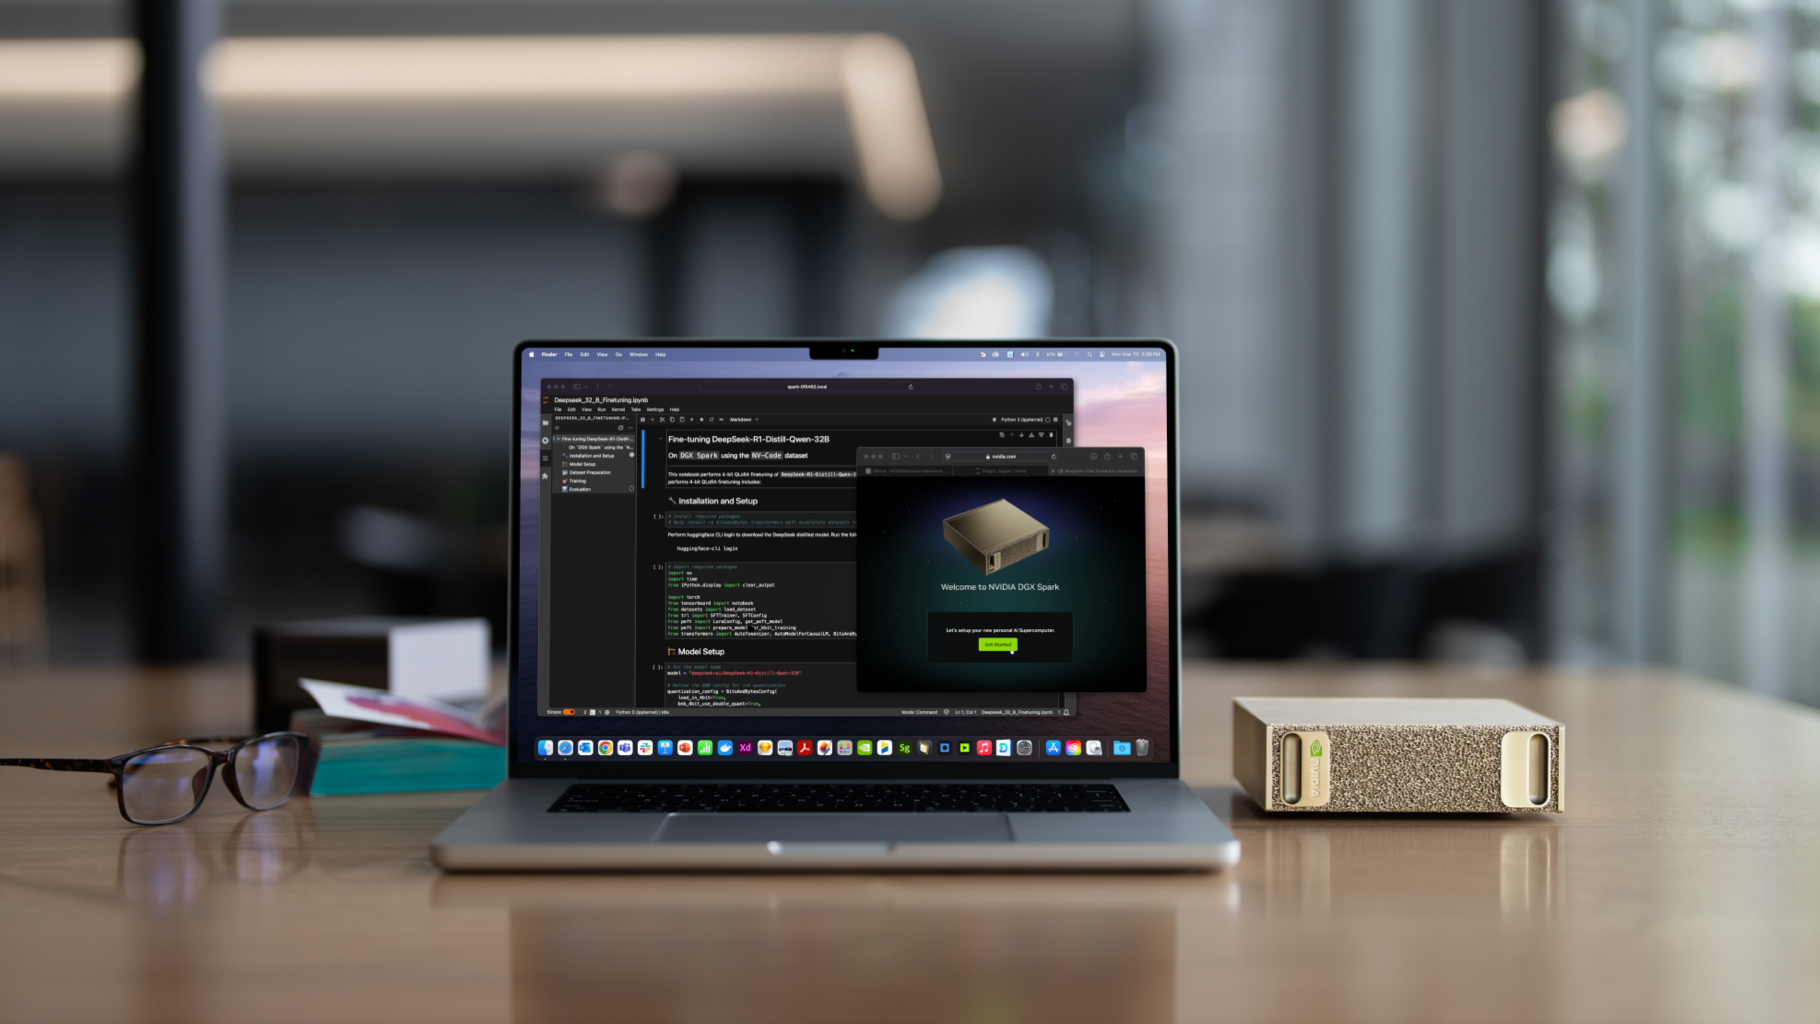
さらに、NVIDIA ConnectX™ ネットワーキングにより、2台のNVIDIA DGX Sparkスーパーコンピュータを接続し、最大405Bパラメータのモデルの推論を可能にします。非常に小さなフォーム ファクター(重量わずか1.2キロ、 L150mm x W150 mm x H50.5 mm )で既存のラップトップやデスクトップシステムでは実行できないAIモデルやワークロードに対応します。

DGX Spark – System Connections
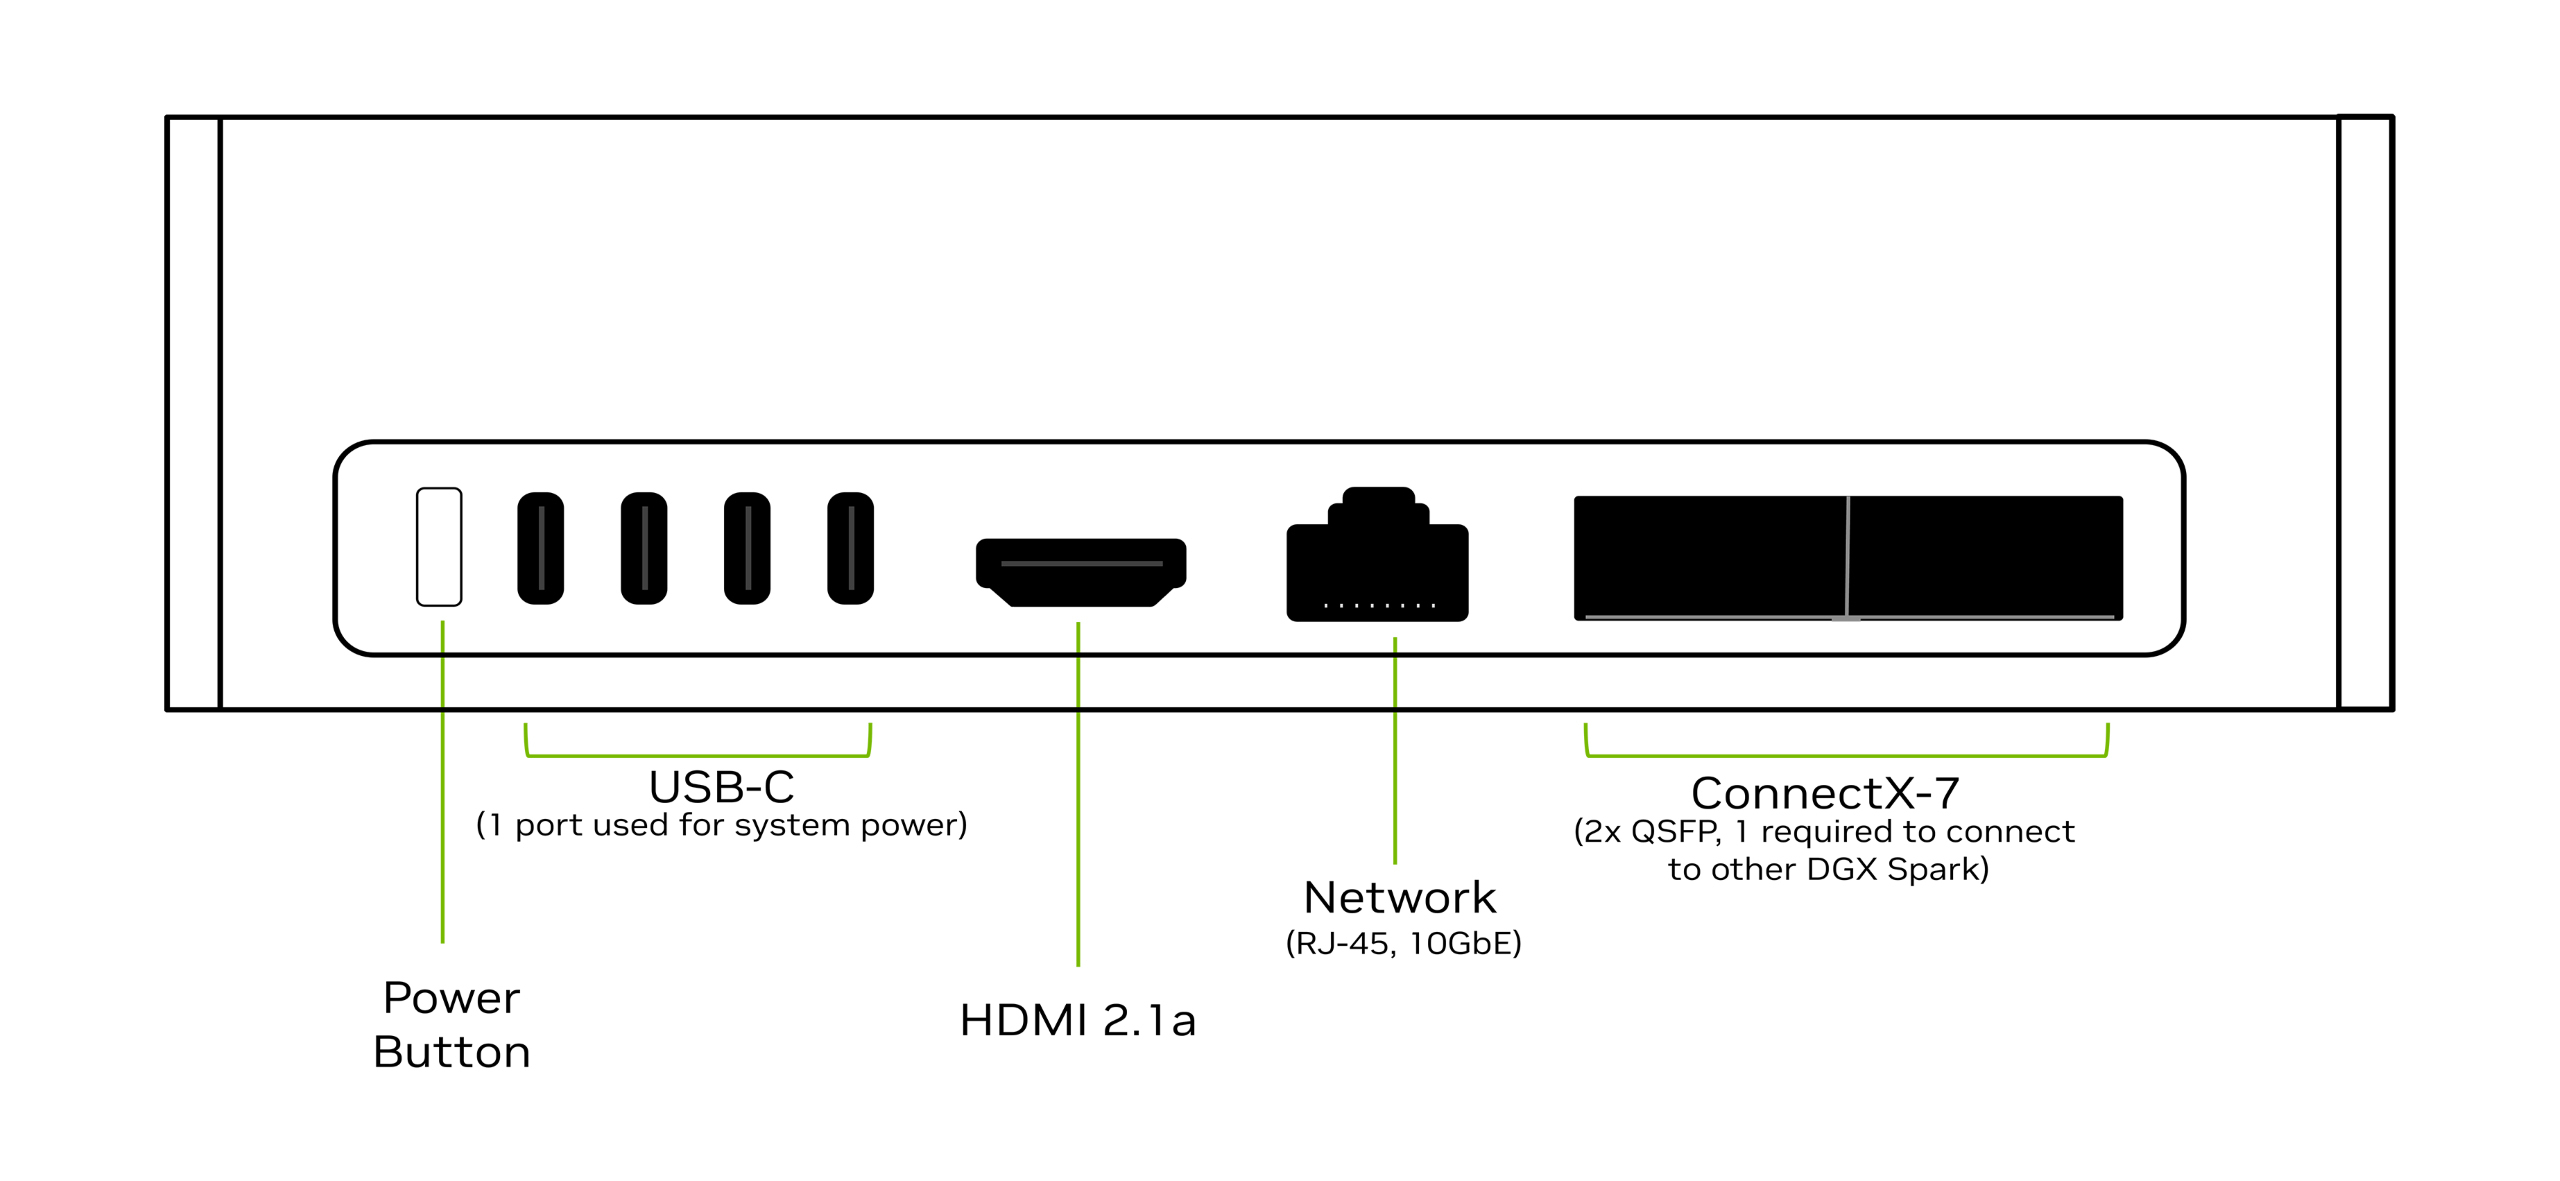
DGX SparkのリアパネルはすべてのI/Oポートが配置されており左側には電源ボタンがあります。
電源ボタンの隣には4つのUSB-Cポートがあります。1つのポートはDGX Sparkに電力を供給するために使用され、残りの3つはユーザーのために空いています。
パネルの中央近くにはHDMI 2.1aポートがあり、ディスプレイをDGX Sparkに直接接続できます。HDMI 2.1aは、最大8Kディスプレイを120Hz HDRまでサポートし、ネットワーク接続はパネルの右側にあります。中央近くにはRJ-45イーサネット接続があり、最大10Gbps(ギガビット毎秒)の速度で通信できるイーサネット(LAN)規格です。
左側にはConnectX-7 200Gbps QSFP接続があります。Quad Small Form-factor Pluggable(QSFP)接続は、高速データレートをサポートします。
ユーザーは、2つのDGX Sparkを接続して、最大405BパラメータのAIモデルに対応できる個人クラスターを作成するためにQSFPケーブルが必要です。また、2つのDGX Sparkシステムを接続するには1つのポートのみが必要となります。
電源ボタンの隣には4つのUSB-Cポートがあります。1つのポートはDGX Sparkに電力を供給するために使用され、残りの3つはユーザーのために空いています。
パネルの中央近くにはHDMI 2.1aポートがあり、ディスプレイをDGX Sparkに直接接続できます。HDMI 2.1aは、最大8Kディスプレイを120Hz HDRまでサポートし、ネットワーク接続はパネルの右側にあります。中央近くにはRJ-45イーサネット接続があり、最大10Gbps(ギガビット毎秒)の速度で通信できるイーサネット(LAN)規格です。
左側にはConnectX-7 200Gbps QSFP接続があります。Quad Small Form-factor Pluggable(QSFP)接続は、高速データレートをサポートします。
ユーザーは、2つのDGX Sparkを接続して、最大405BパラメータのAIモデルに対応できる個人クラスターを作成するためにQSFPケーブルが必要です。また、2つのDGX Sparkシステムを接続するには1つのポートのみが必要となります。

スケーラブルソリューション
DGX Sparkは、産業用向けにAI製品やサービスを生産するためのシステムやプロセスを稼働する際、システムの設計と開発における基盤となるソフトウェアアーキテクチャを搭載しています。Ubuntu Linuxを搭載したNVIDIA DGX OSを使用し、最新のNVIDIA AIソフトウェアスタックで事前構成され、NVIDIA NIM™ とNVIDIAブループリントへの開発者プログラムアクセスとともに、開発者はPytorch、Jupyter、Ollamaなどの一般的なツールを使用して、DGX Spark上でプロトタイプ作成、微調整、推論を行い、データセンターやクラウドにシームレスに展開することができます。
DGX Sparkは、開発者、研究者、データサイエンティスト、および学生が、コンパクトなパッケージで大規模な生成AIパフォーマンスを発揮することを可能にします。
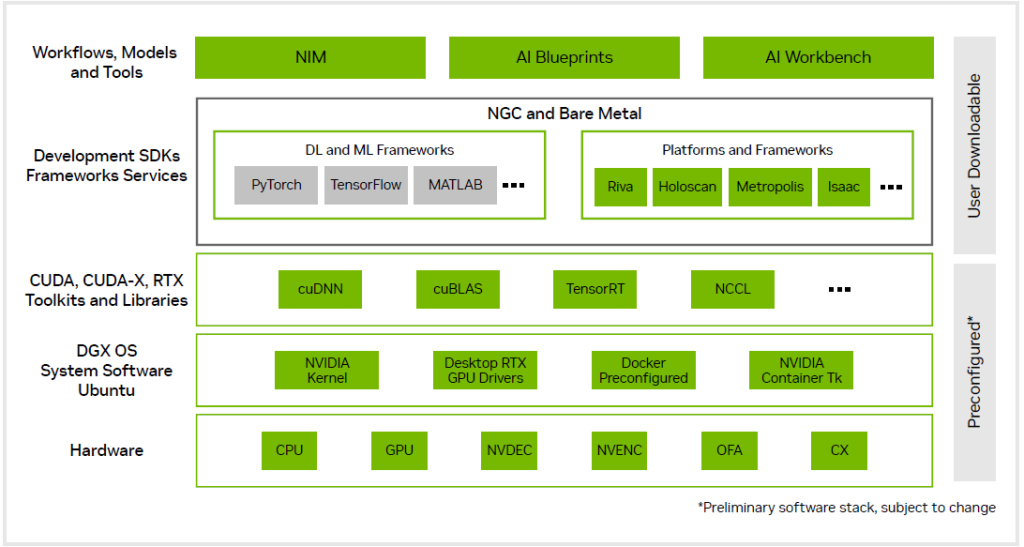
DGX Sparkは、開発者、研究者、データサイエンティスト、および学生が、コンパクトなパッケージで大規模な生成AIパフォーマンスを発揮することを可能にします。

DGX Sparkとその他のAIシステム環境の比較
AI開発のためのシステム環境を検討する際、ハイエンドのワークステーションGPUのうちの2つがメモリとして稼働しますが、開発者がラップトップやデスクトップシステムを追加しようとする場合、コストが高くなります。
データセンターやクラウドは、膨大なコンピューティング容量とメモリ容量を必要とするため、AI開発者はデータセンターのリソースや、クラウドインスタンスの予算を確保したりする必要があります。
その点、DGX Spark は、デスクトップ デバイス上でより大きな AI モデルやワークロードで作業する必要がある AI 開発者に最適です。
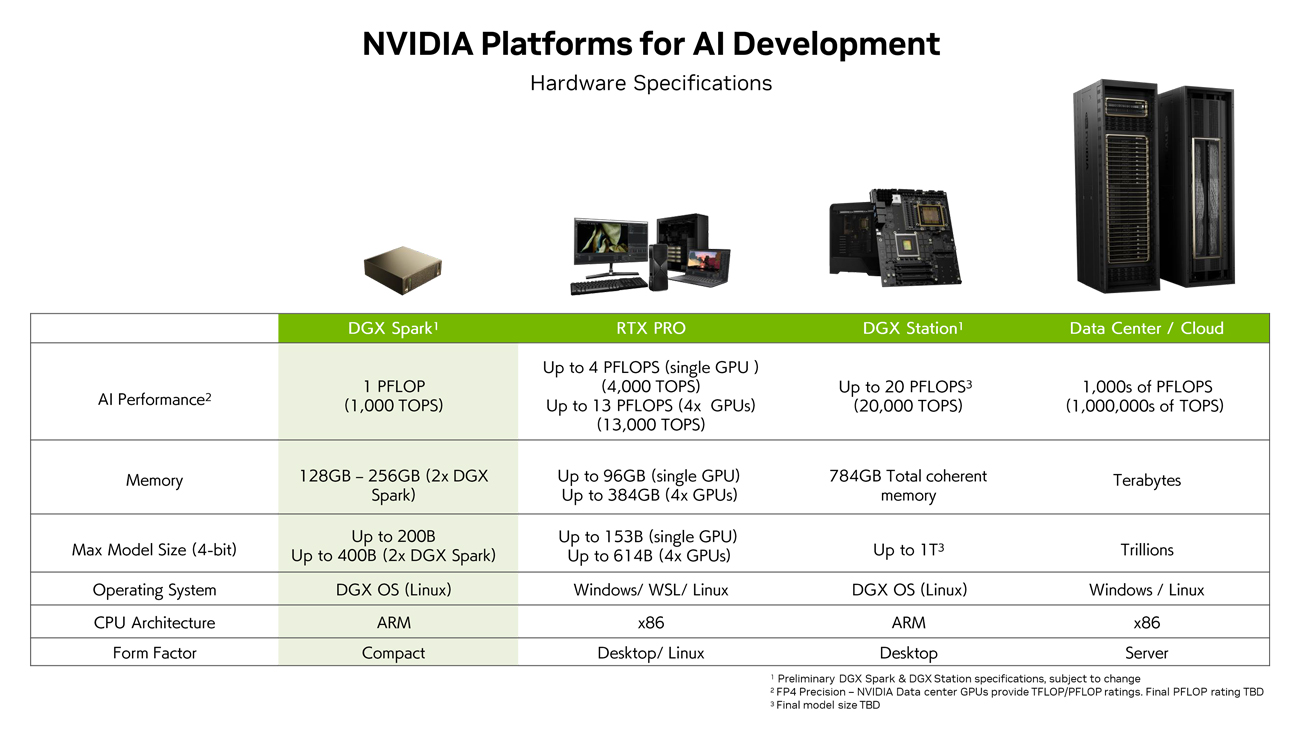
データセンターやクラウドは、膨大なコンピューティング容量とメモリ容量を必要とするため、AI開発者はデータセンターのリソースや、クラウドインスタンスの予算を確保したりする必要があります。
その点、DGX Spark は、デスクトップ デバイス上でより大きな AI モデルやワークロードで作業する必要がある AI 開発者に最適です。

DGX Sparkの利点
DGX Spark は、大規模なモデルで最大 200B のパラメーターの AI ワークロードをローカルで実行できます。
また、NVIDIA AI ソフトウェア スタックは、AI を構築および実行でき、データはローカルに保持されるため、外部の場所にデータを転送する必要がありません。AIクラウド - データセンターのコンピューティングやクラウドインスタンスの費用は必要なく、大規模AIモデルの構築の際は2つのDGX Sparkを接続して作業ができます。
NVIDIA AIソフトウェアスタックにより開発者がAIを構築・実行するために必要なすべてのツールを提供され、追加のコンピューティングやデプロイのために、作業をクラウドやデータセンターに簡単に移行することもできます。
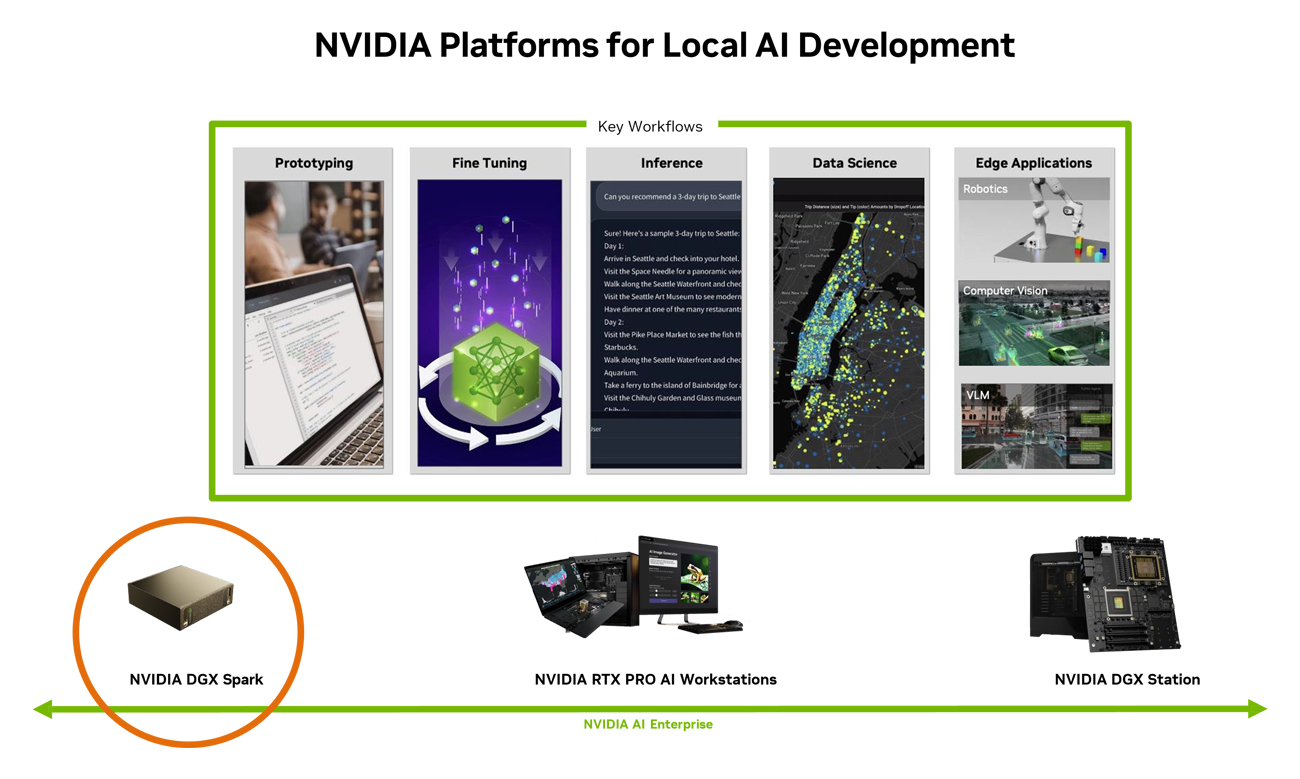
また、NVIDIA AI ソフトウェア スタックは、AI を構築および実行でき、データはローカルに保持されるため、外部の場所にデータを転送する必要がありません。AIクラウド - データセンターのコンピューティングやクラウドインスタンスの費用は必要なく、大規模AIモデルの構築の際は2つのDGX Sparkを接続して作業ができます。
NVIDIA AIソフトウェアスタックにより開発者がAIを構築・実行するために必要なすべてのツールを提供され、追加のコンピューティングやデプロイのために、作業をクラウドやデータセンターに簡単に移行することもできます。

| アーキテクチャ | NVIDIA Grace Blackwell |
|---|---|
| GPU | Blackwellアーキテクチャ |
| CPU | 20コアArm、Cortex-X925 x10 + Cortex-A725 x10 |
| CUDA コア | Blackwell世代 |
| Tensor コア | 第5世代 |
| RT コア | 第4世代 |
| Tensor性能※1 | 1,000 AI TOPS |
| システムメモリー | 128 GB LPDDR5x、統合システムメモリー |
| メモリーインターフェース | 256-bit |
| メモリー帯域幅 | 273 GB/s |
| OS | DGX OS |
| ストレージ | 1 TBまたは4 TB NVMe M.2(自己暗号化対応) |
| USB | USB Type-C x4 |
| Ethernet | 10 GbE |
| RJ-45コネクター x1 | |
| NIC | ConnectX-7 SmartNIC |
| Wi-Fi | Wi-Fi 7 |
| Bluetooth | Bluetooth 5.3 |
| オーディオ出力 | HDMIマルチチャネルオーディオ出力 |
| 消費電力 | 240 W |
| ディスプレイコネクター | HDMI 2.1a x1 |
| NVENC / NVDEC | x1 / x1 |
| サイズ | 150 mm(W) × 50.5 mm(H) × 150 mm(D) |
| 重量 | 1.2 kg |
| ※1 スパース性機能を使用した理論上のFP4性能値。 |
製品名・スペックから検索


- AIワークステーション
- DeepLearningBOXIII
- DeepLearningBOXIII/Win
- DeepLearningSTATIONII
- DeepLearningSTATIONII AP
- Ai Compute BOX Silent
- Ai Compute BOX mini
- NVIDIA DGX™ Spark
- GPUワークステーション


-
ご購入に関するご相談・お問い合わせ
-
uniVは完全オーダーメイドで
お客様のご希望の仕様に合わせて
製造することが可能です。
お気軽にお問い合わせください。
-